Крупнейшие ИИ-компании поддержали единый способ отказаться от сбора данных с сайтов
OpenAI, Google, Microsoft и Anthropic заявили, что поддержат новый стандарт, который позволит издателям сайтов сообщать ИИ-компаниям, что они не разрешают использовать материалы своих страниц для обучения моделей. Такой сигнал можно будет задать в файле robots.txt — сейчас издателям приходится настраивать ограничения отдельно для каждой компании.
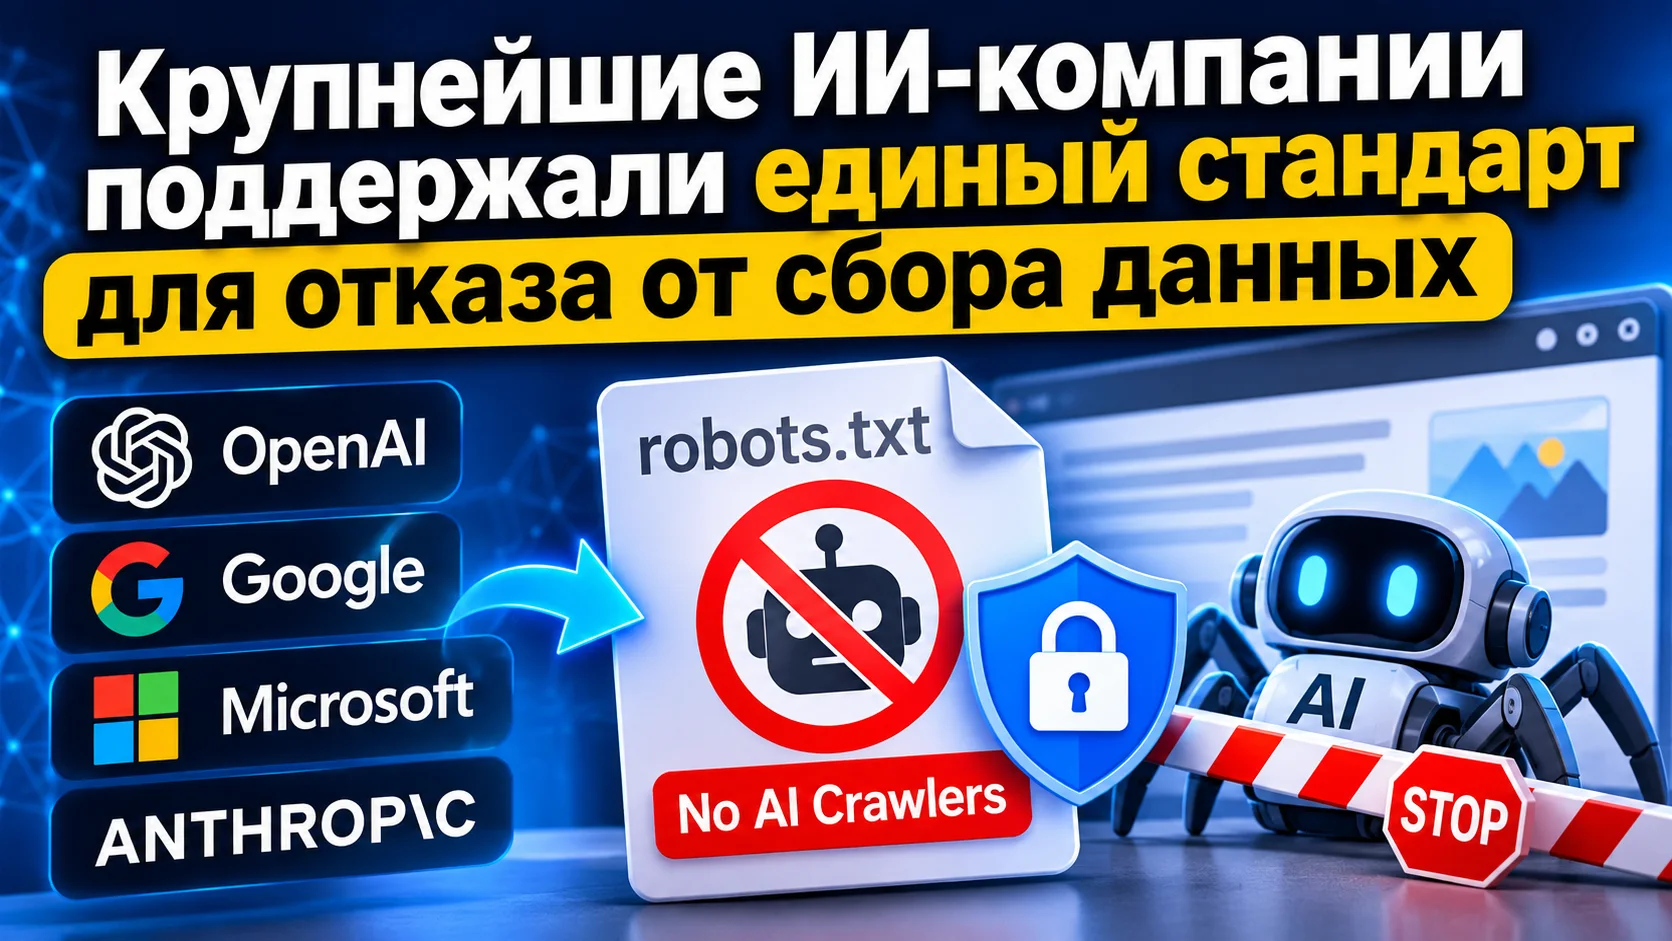
Предложение предусматривает общий «токен политики» (policy token). Его разработку продвигает Кевин Келли, специалист Anthropic по техническим стандартам, в рамках Рабочей группы по инженерным вопросам интернета (IETF).
Компании заявили, что их ИИ-краулеры будут учитывать этот сигнал и не станут обращаться к сайтам, которые его используют. Anthropic уже внедрила поддержку стандарта. Google и Microsoft планируют сделать это в следующем году, а OpenAI рассчитывает внедрить его в ближайшие месяцы.
Издатели всё чаще обеспокоены тем, что ИИ-краулеры собирают содержимое их сайтов и используют его для обучения моделей. Ранее появлялись и другие способы ограничить такой сбор: например, стандарт Really Simple Licensing (RSL) позволяет издателям взимать плату с краулеров, а Cloudflare по умолчанию блокирует ИИ-краулеры.
Meta также выразила поддержку общей системе сигналов, однако пока не подтвердила, что будет соблюдать её. Представитель компании заявил, что единый сигнал, передающий предпочтения издателей сразу нескольким поставщикам, — важный шаг, и Meta готова работать над стандартом вместе с другими ИИ-компаниями.
Microsoft обещает предоставить издателям более точные настройки: отдельно запрещать использование материалов для обучения ИИ или для AI grounding — предоставления модели проверенных источников, чтобы снизить число ошибок. При этом сайты продолжат отображаться в результатах поиска Bing независимо от выбранных настроек.
Google уже предлагает похожие параметры: издатели могут управлять использованием своих материалов в ИИ-функциях поиска и обучении моделей, не теряя видимости в обычной поисковой выдаче.
Комментарии
Загружаем комментарии…